Chatbots multimodales: lo que fotos, archivos y respuestas enriquecidas logran hoy
Los chatbots multimodales entienden más que texto escrito. Esto es lo que funciona hoy en el chat con clientes, desde fotos y PDF hasta la búsqueda por foto, las fichas de producto y las tablas, en qué punto están la voz y el vídeo, y cómo decidir qué necesita tu web.
- Autor
- intoCHAT Team
- Publicado
- Última actualización
- Tiempo de lectura
- 5 min de lectura
En esta página
Durante años, un chatbot era una caja de texto. Los modelos de IA actuales también leen fotos, capturas de pantalla y documentos, y los widgets de chat pueden responder con fichas de producto, tablas y botones en lugar de un muro de texto. Eso cambia lo que puede hacer un chatbot web. Este artículo explica qué significa «multimodal» en la práctica, qué funciona ya bien en el chat con clientes, en qué punto están la voz y el vídeo, y cómo decidir qué necesita tu web.
¿Qué hace que un chatbot sea multimodal?
Un chatbot multimodal maneja más que texto escrito, en dos direcciones:
- Entrada: imágenes (fotos de productos, capturas de pantalla, fotos de daños), documentos como PDF y, en algunos sistemas, voz o vídeo.
- Salida: además de texto, elementos estructurados como fichas de producto, tablas comparativas, tarjetas con imágenes, botones de respuesta rápida, formularios o un selector de horarios.
El valor está en combinarlos. «¿Lo tenéis en azul?» con una foto es una petición más clara que cualquiera de las dos partes por separado.
Lo que funciona bien hoy
Leer fotos y capturas de pantalla
Los modelos actuales describen con fiabilidad lo que hay en una foto: el tipo de producto, su color, material, estilo, una marca impresa o el texto de un mensaje de error en una captura. En el chat con clientes, esto ahorra el ir y venir de «¿puedes describirlo?». Un cliente envía la foto de una mesa rayada y pregunta por una devolución; una usuaria envía una captura de un error y pregunta qué hacer.
Leer documentos
Una factura en PDF, una confirmación de pedido o un formulario rellenado pueden leerse junto con la pregunta. «¿Por qué me han cobrado dos veces?» junto a la factura se responde más rápido que con el número de factura tecleado.
Búsqueda por foto
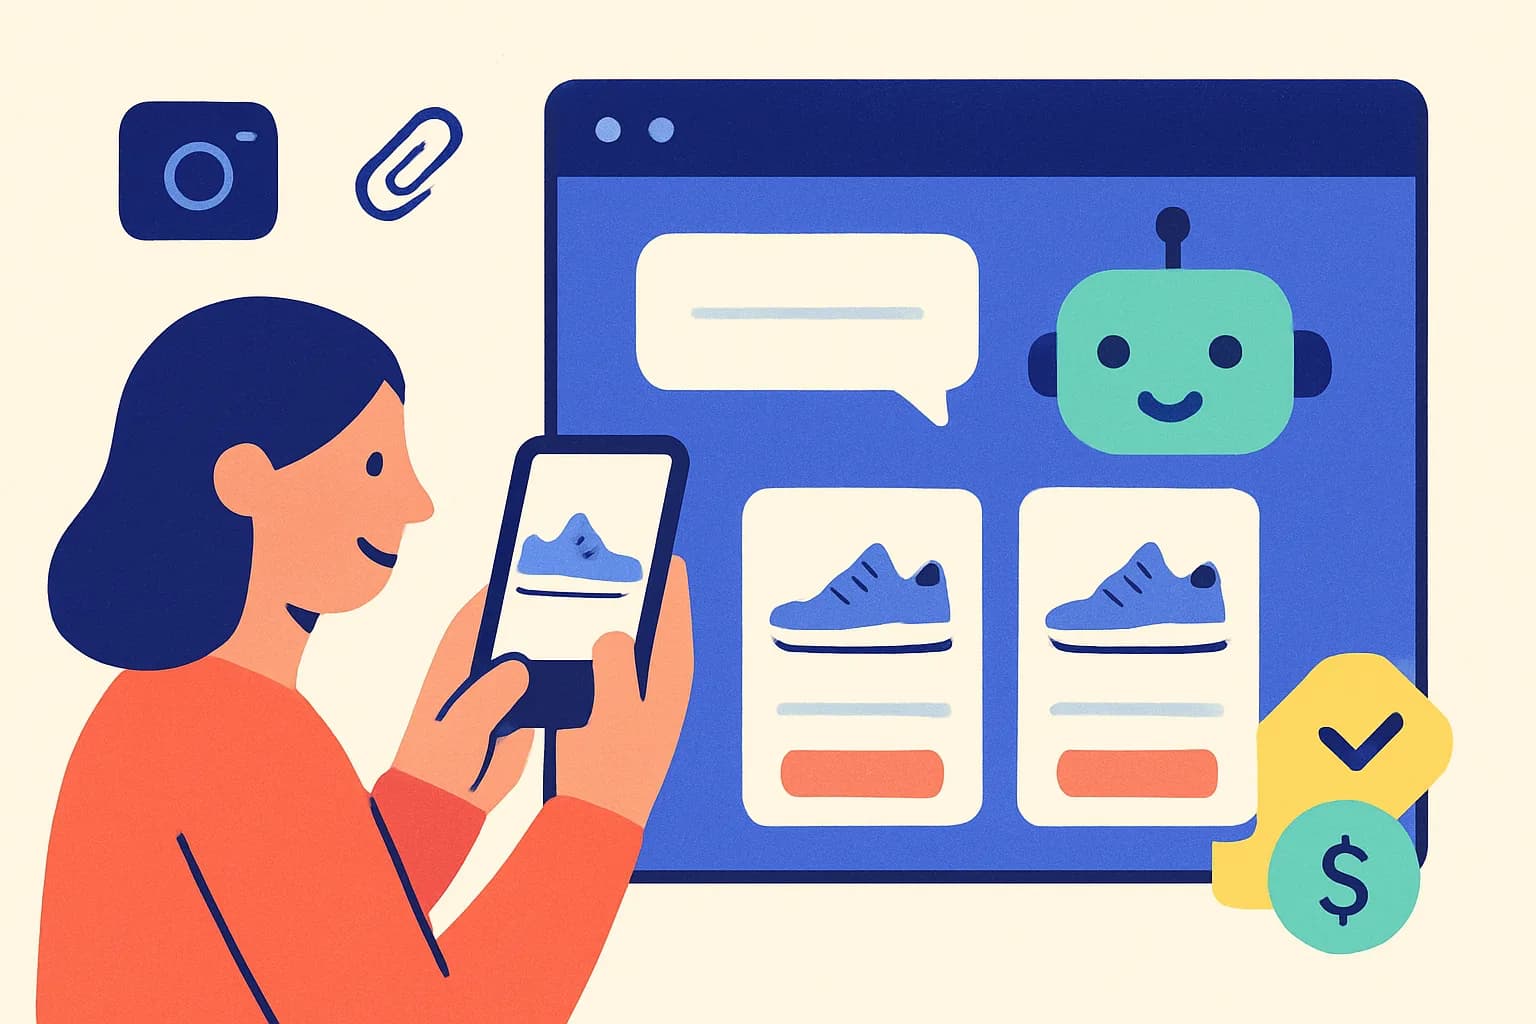
El caso comercial más claro. Alguien vio una lámpara en una cafetería o una chaqueta que llevaba una amiga, pero no sabe cómo se llama. Envía la foto, el chatbot describe el artículo, busca en el catálogo de la tienda y muestra productos similares. «No sé cómo se llama» se convierte en una página de producto.
Respuestas enriquecidas
La salida multimodal importa tanto como la entrada. Una comparación de tres planes se lee mejor como tabla, una selección de productos como tarjetas con imágenes y precios, y un siguiente paso evidente como botón. Bien hecho, el chatbot elige el formato en cada respuesta y deja el texto para lo que se dice mejor con palabras.
En qué punto están la voz y el vídeo
El reconocimiento y la síntesis de voz están maduros en general, y los agentes de voz telefónicos van en aumento. Pero la voz es un proyecto aparte del chat web: necesita voz a texto y texto a voz además del modelo de lenguaje, añade latencia y costes, y plantea sus propias preguntas de diseño, desde acentos y dialectos hasta qué pasa cuando quien llama interrumpe. La comprensión de vídeo en directo en atención al cliente aún está empezando. Para la mayoría de las webs, las fotos y los documentos aportan hoy más valor con una fracción del esfuerzo.
Retos que debes prever
- Privacidad. Las fotos pueden mostrar personas, direcciones o números de documentos. Deben guardarse de forma privada con la conversación, borrarse con ella y no añadirse nunca al conocimiento del bot.
- Precisión. Los modelos pueden malinterpretar una foto. El bot debe preguntar si tiene dudas y no inventar nunca productos, precios ni disponibilidad.
- Velocidad. Leer una imagen y buscar en un catálogo añade unos segundos a la respuesta.
- Abuso y costes. Las subidas necesitan límites de tamaño y frecuencia, y las búsquedas por imagen un tope diario para que no disparen los costes.
Cómo gestiona intoCHAT imágenes, archivos y respuestas enriquecidas
Los agentes de intoCHAT responden en texto a partir de tu propio contenido y añaden imágenes, documentos y elementos enriquecidos donde ayudan:
- Adjuntos de visitantes. Activa Let visitors attach files y los visitantes envían imágenes (PNG, JPEG, WebP, GIF) y PDF con el clip, arrastrándolos o pegando una captura, hasta 3 archivos de 4 MB por mensaje. El agente los lee con el mensaje. Todos los modelos leen imágenes; los PDF los leen los modelos de OpenAI. Un mensaje con archivos cuenta igual que uno sin ellos.
- Búsqueda por foto (desde Starter). Con una tienda conectada, el agente describe la foto, busca en tu catálogo y muestra hasta 6 productos coincidentes como fichas, el más parecido primero. Tiene instrucciones de ignorar a las personas de la foto y de no tratar como búsqueda las fotos de envíos dañados o las preguntas sobre pedidos. Starter incluye 50 búsquedas por foto por agente al día, Pro 200.
- Fichas de producto de tu catálogo en tiempo real, con imagen, precio, disponibilidad y enlace.
- Respuestas enriquecidas en todos los planes: tablas de hasta 8 columnas, tarjetas con imágenes y precios y botones de respuesta rápida, sin mensaje adicional.
- Pasos interactivos en el chat: un carrito con checkout, formularios de chat y un selector de horarios para reservar con Cal.com o Calendly.
Los archivos se envían al proveedor del modelo que elijas para redactar la respuesta, se guardan de forma privada con la conversación y se borran con ella. intoCHAT no ofrece entrada por voz ni canal telefónico, y el agente de email responde a partir del texto de un correo, no de sus adjuntos.
¿Debe tu web volverse multimodal?
- Empieza por el texto. Entrena un agente con tu web y tus documentos; cubre la mayoría de las preguntas sobre precios, políticas, productos y procedimientos.
- Lee tus conversaciones. Cuenta cuántas veces los visitantes intentan describir algo que una foto mostraría: un daño, un error, un producto que vieron en otro sitio.
- Activa los adjuntos si ocurre a menudo, e indica al agente en sus instrucciones qué hacer con las fotos.
- Añade la búsqueda por foto si tienes una tienda con productos que se encuentran más por su aspecto que por su nombre, como moda, muebles o decoración.
- Usa respuestas enriquecidas para comparaciones y siguientes pasos. Vienen activadas por defecto.
Crea tu agente gratis, activa los adjuntos y envíale una foto en el Playground, o compara los planes.
Preguntas frecuentes
¿Qué es un chatbot multimodal?
Un chatbot multimodal entiende más de un tipo de entrada, como texto, imágenes, documentos, voz o vídeo, y puede responder con algo más que texto plano, por ejemplo fichas de producto, tablas o botones. Combina estas entradas para entender mejor una petición, como la foto de un producto junto a una pregunta escrita.
¿Qué puede hacer un chatbot multimodal en e-commerce y atención al cliente?
En e-commerce, el caso más útil hoy es la búsqueda por foto: un cliente envía una imagen y el chatbot muestra productos similares de la tienda. En soporte, los clientes envían la foto de un envío dañado, una captura de un mensaje de error o una factura en PDF, y el chatbot la lee junto con su pregunta en lugar de pedirles que la describan.
¿Es intoCHAT un chatbot multimodal?
Para imágenes y documentos, sí. Con los adjuntos de visitantes activados, los visitantes envían imágenes y PDF que el agente lee junto con su mensaje. Con una tienda conectada, la búsqueda por foto (desde Starter) muestra los productos coincidentes como fichas. Las respuestas pueden incluir fichas de producto, tablas, tarjetas con imágenes y botones de respuesta rápida, un carrito, formularios y horarios de reserva. intoCHAT no ofrece entrada por voz ni canal telefónico.
¿Qué modelos de IA leen imágenes y PDF en intoCHAT?
Todos los modelos de intoCHAT leen imágenes: GPT-6 Luna, Claude y Gemini. Los PDF solo los leen los modelos de OpenAI; con un modelo de Claude o Gemini, el agente sabe que se adjuntó un PDF y responde a partir de lo que escribió el visitante. Un mensaje con archivos cuenta igual que uno sin ellos.
¿Cuáles son los retos de los chatbots multimodales?
Las imágenes pueden contener datos personales, así que el proveedor debe guardarlas de forma privada y no añadirlas al conocimiento del bot. El análisis de imágenes añade unos segundos a la respuesta y los modelos pueden malinterpretar una foto, así que el bot debe preguntar si tiene dudas y no inventar nunca productos. La voz añade reconocimiento de voz, latencia y costes, y es un proyecto aparte del chat de texto.
¿Necesita mi web hoy un chatbot multimodal?
Empieza con un agente de texto entrenado con tu propio contenido, porque cubre la mayoría de las preguntas. Después activa los adjuntos si los visitantes describen a menudo cosas que una foto mostraría más rápido, como daños, errores o productos que buscan. Revisa tus conversaciones antes de invertir en voz.