Chatbots multimodaux : ce que photos, fichiers et réponses enrichies permettent aujourd’hui
Les chatbots multimodaux comprennent plus que du texte saisi. Ce qui fonctionne aujourd’hui dans le chat client, des photos et PDF à la recherche par photo, aux fiches produit et aux tableaux, où en sont la voix et la vidéo, et comment décider de ce dont votre site a besoin.
- Auteur
- intoCHAT Team
- Publié
- Dernière mise à jour
- Temps de lecture
- 5 min de lecture
Sur cette page
Pendant des années, un chatbot se résumait à une zone de texte. Les modèles d’IA actuels lisent aussi des photos, des captures d’écran et des documents, et les widgets de chat peuvent répondre avec des fiches produit, des tableaux et des boutons plutôt qu’avec un pavé de texte. Cela change ce qu’un chatbot de site web peut faire. Cet article explique ce que « multimodal » signifie concrètement, ce qui fonctionne déjà bien dans le chat client, où en sont la voix et la vidéo, et comment décider de ce dont votre site a besoin.
Qu’est-ce qui rend un chatbot multimodal ?
Un chatbot multimodal traite plus que du texte saisi, dans deux directions :
- Entrée : des images (photos de produits, captures d’écran, photos de dommages), des documents comme des PDF et, dans certains systèmes, la voix ou la vidéo.
- Sortie : en plus du texte, des éléments structurés comme des fiches produit, des tableaux comparatifs, des cartes avec images, des boutons de réponse rapide, des formulaires ou un sélecteur de créneaux.
La valeur tient à leur combinaison. « L’avez-vous en bleu ? » accompagné d’une photo est une demande plus claire que chacune des deux parties seule.
Ce qui fonctionne bien aujourd’hui
Lire des photos et des captures d’écran
Les modèles actuels décrivent de façon fiable le contenu d’une photo : le type de produit, sa couleur, sa matière, son style, une marque imprimée dessus ou le texte d’un message d’erreur sur une capture d’écran. Dans le chat client, cela évite les allers-retours du type « pouvez-vous le décrire ? ». Un client envoie la photo d’un plateau de table rayé et demande un retour ; une utilisatrice envoie une capture d’écran d’une erreur et demande quoi faire.
Lire des documents
Une facture PDF, une confirmation de commande ou un formulaire rempli peut être lu avec la question. « Pourquoi ai-je été débité deux fois ? » à côté de la facture obtient une réponse plus rapide qu’avec le numéro de facture tapé à la main.
Recherche par photo
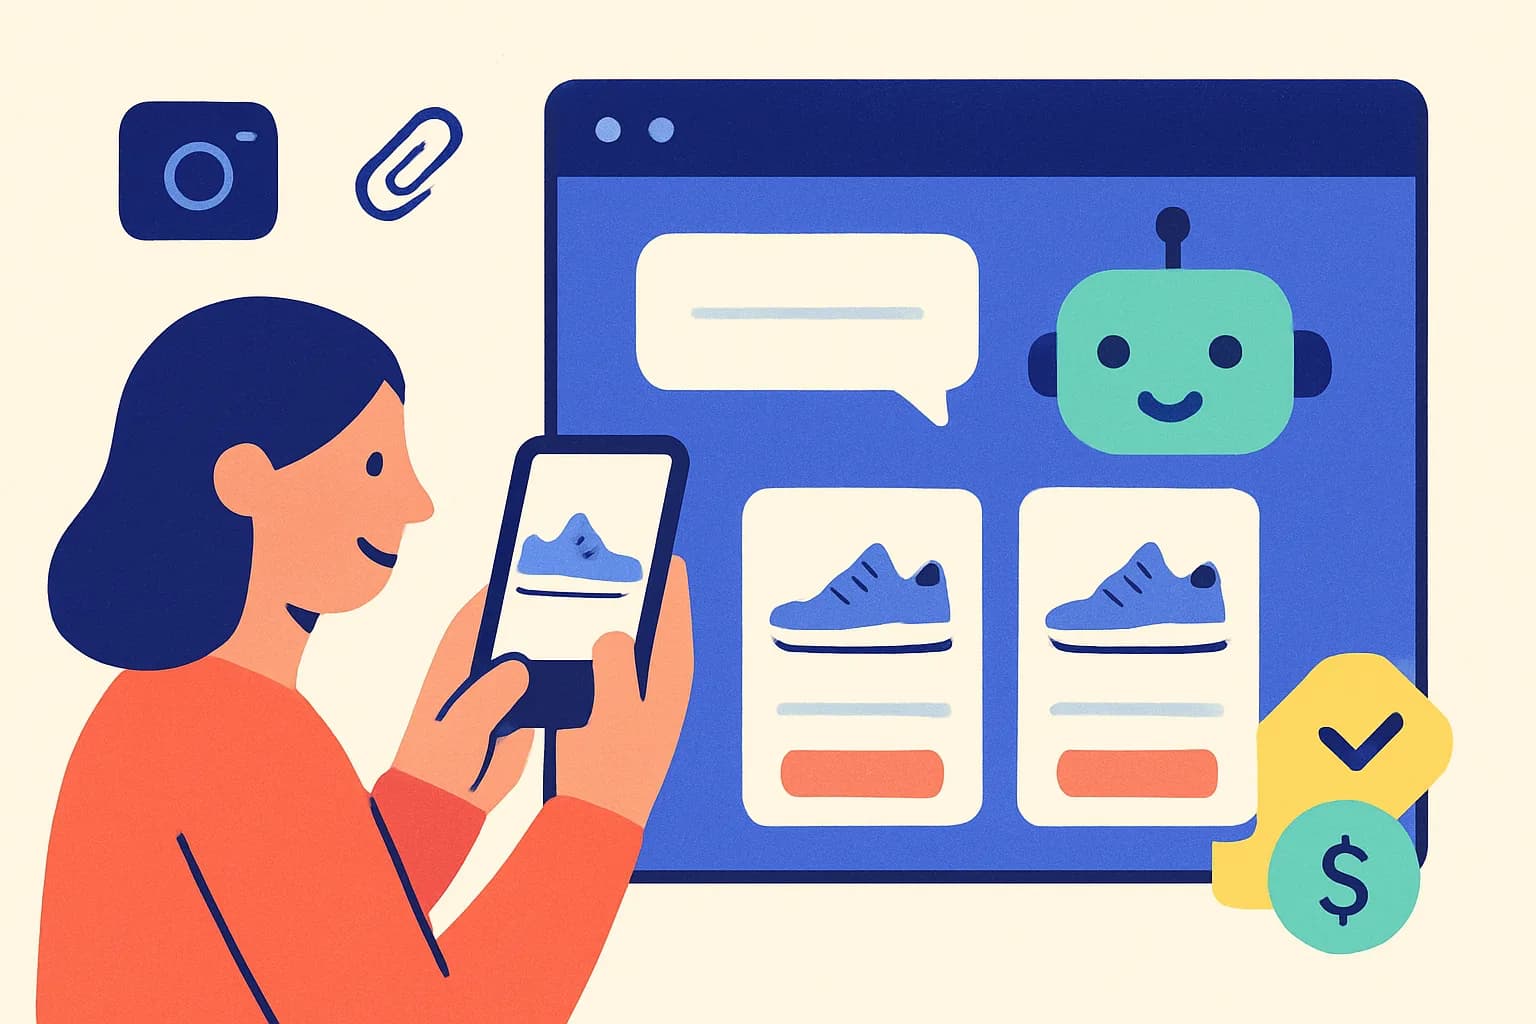
Le cas commercial le plus évident. Quelqu’un a vu une lampe dans un café ou une veste portée par une amie, mais ne sait pas comment elle s’appelle. Il envoie la photo, le chatbot décrit l’article, cherche dans le catalogue de la boutique et affiche des produits similaires. « Je ne sais pas comment ça s’appelle » devient une page produit.
Réponses enrichies
La sortie multimodale compte autant que l’entrée. Une comparaison de trois offres se lit mieux sous forme de tableau, un choix de produits sous forme de cartes avec images et prix, et une étape suivante évidente sous forme de bouton. Bien conçu, le chatbot choisit le format à chaque réponse et garde le texte pour ce qui se dit mieux avec des mots.
Où en sont la voix et la vidéo
La reconnaissance et la synthèse vocales sont matures en général, et les agents vocaux au téléphone se développent. Mais la voix est un projet distinct du chat sur site web : elle nécessite la transcription et la synthèse vocales en plus du modèle de langage, ajoute latence et coûts, et soulève ses propres questions de conception, des accents et dialectes à ce qui se passe quand l’appelant interrompt. La compréhension vidéo en direct dans le service client n’en est qu’à ses débuts. Pour la plupart des sites, les photos et les documents apportent aujourd’hui plus de valeur, pour une fraction de l’effort.
Les défis à anticiper
- Confidentialité. Les photos peuvent montrer des personnes, des adresses ou des numéros de documents. Elles doivent être stockées de façon privée avec la conversation, supprimées avec elle, et jamais ajoutées aux connaissances du bot.
- Précision. Les modèles peuvent mal interpréter une photo. Le bot doit demander en cas de doute et ne jamais inventer de produits, de prix ou de disponibilités.
- Rapidité. Lire une image et chercher dans un catalogue ajoute quelques secondes à une réponse.
- Abus et coûts. Les envois de fichiers ont besoin de limites de taille et de fréquence, et les recherches par image d’un plafond quotidien pour éviter que les coûts s’envolent.
Comment intoCHAT gère les images, les fichiers et les réponses enrichies
Les agents intoCHAT répondent en texte à partir de vos propres contenus, et ajoutent images, documents et éléments enrichis là où ils sont utiles :
- Pièces jointes des visiteurs. Activez Let visitors attach files et les visiteurs envoient des images (PNG, JPEG, WebP, GIF) et des PDF avec le trombone, par glisser-déposer ou en collant une capture d’écran, jusqu’à 3 fichiers de 4 Mo par message. L’agent les lit avec le message. Tous les modèles lisent les images ; les PDF sont lus par les modèles d’OpenAI. Un message avec fichiers compte autant qu’un message sans.
- Recherche par photo (dès Starter). Avec une boutique connectée, l’agent décrit la photo, cherche dans votre catalogue et affiche jusqu’à 6 produits correspondants sous forme de fiches, le plus proche en premier. Il a pour consigne d’ignorer les personnes sur la photo et de laisser de côté les photos de livraisons endommagées ou les questions de commande. Starter inclut 50 recherches par photo par agent et par jour, Pro 200.
- Fiches produit issues de votre catalogue en direct, avec image, prix, état du stock et lien.
- Réponses enrichies dans toutes les offres : tableaux jusqu’à 8 colonnes, cartes avec images et prix, et boutons de réponse rapide, sans message supplémentaire.
- Étapes interactives dans le chat : un panier avec paiement, des formulaires de chat et un sélecteur de créneaux pour réserver via Cal.com ou Calendly.
Les fichiers sont envoyés au fournisseur du modèle que vous choisissez pour rédiger la réponse, stockés de façon privée avec la conversation et supprimés avec elle. intoCHAT ne propose ni saisie vocale ni canal téléphonique, et l’agent e-mail répond à partir du texte d’un e-mail, pas de ses pièces jointes.
Votre site doit-il passer au multimodal ?
- Commencez par le texte. Entraînez un agent sur votre site et vos documents ; il couvre la plupart des questions sur les prix, les conditions, les produits et les procédures.
- Lisez vos conversations. Comptez combien de fois les visiteurs tentent de décrire ce qu’une photo montrerait : un dommage, une erreur, un produit vu ailleurs.
- Activez les pièces jointes si cela arrive souvent, et indiquez à l’agent dans ses instructions quoi faire des photos.
- Ajoutez la recherche par photo si vous gérez une boutique dont les produits se trouvent plutôt par leur apparence que par leur nom, comme la mode, les meubles ou la décoration.
- Utilisez les réponses enrichies pour les comparaisons et les étapes suivantes. Elles sont activées par défaut.
Créez votre agent gratuitement, activez les pièces jointes et envoyez-lui une photo dans le Playground, ou comparez les offres.
Questions fréquentes
Qu’est-ce qu’un chatbot multimodal ?
Un chatbot multimodal comprend plus d’un type d’entrée, comme le texte, les images, les documents, la voix ou la vidéo, et peut répondre avec autre chose que du texte brut, par exemple des fiches produit, des tableaux ou des boutons. Il combine ces entrées pour mieux comprendre une demande, comme la photo d’un produit accompagnée d’une question écrite.
Que peut faire un chatbot multimodal dans l’e-commerce et le service client ?
Dans l’e-commerce, le cas le plus utile aujourd’hui est la recherche par photo : un client envoie une image et le chatbot affiche des produits similaires de la boutique. Dans le support, les clients envoient la photo d’une livraison endommagée, une capture d’écran d’un message d’erreur ou une facture PDF, et le chatbot la lit avec leur question au lieu de leur demander de la décrire.
intoCHAT est-il un chatbot multimodal ?
Pour les images et les documents, oui. Lorsque les pièces jointes des visiteurs sont activées, ceux-ci envoient des images et des PDF que l’agent lit avec leur message. Avec une boutique connectée, la recherche par photo (dès Starter) affiche les produits correspondants sous forme de fiches. Les réponses peuvent inclure des fiches produit, des tableaux, des cartes avec images et des boutons de réponse rapide, un panier, des formulaires et des créneaux de réservation. intoCHAT ne propose ni saisie vocale ni canal téléphonique.
Quels modèles d’IA lisent les images et les PDF dans intoCHAT ?
Tous les modèles d’intoCHAT lisent les images : GPT-6 Luna, Claude et Gemini. Les PDF ne sont lus que par les modèles d’OpenAI ; avec un modèle Claude ou Gemini, l’agent est informé qu’un PDF a été joint et répond à partir de ce que le visiteur a écrit. Un message avec fichiers compte autant qu’un message sans.
Quels sont les défis des chatbots multimodaux ?
Les images peuvent contenir des données personnelles : le fournisseur doit donc les stocker de façon privée et ne pas les ajouter aux connaissances du bot. L’analyse d’image ajoute quelques secondes à une réponse et les modèles peuvent mal interpréter une photo : le bot doit demander en cas de doute et ne jamais inventer de produits. La voix ajoute reconnaissance vocale, latence et coûts, et constitue un projet distinct du chat textuel.
Mon site a-t-il besoin d’un chatbot multimodal aujourd’hui ?
Commencez par un agent textuel entraîné sur vos propres contenus, car il couvre la plupart des questions. Activez ensuite les pièces jointes si les visiteurs décrivent souvent ce qu’une photo montrerait plus vite, comme un dommage, une erreur ou un produit qu’ils cherchent. Analysez vos conversations avant d’investir dans la voix.